
Droid ASC:极速 Android 反编译引擎,比JADX快41~269倍
本文介绍一个面向 AI Agent/移动安全研究者 的安卓反编译器 ASC,目前它中稿了 BlackHat EU 2026 Arsenal,可通过 pip install droidasc 安装使用
后Agent时代,AI分析取代了大部分工程化的静态分析理论,并以惊人的速度统治了代码分析领域,但现有的反编译引擎仍然面向人类,从产物中构建达数GB的CFG, AST, Xrefs…,但Agent需要的仅仅是代码(Agent only wantS Code),我们采用了极端的懒加载策略并利用R8编译器的优化原语,编写了Agent友好的极速反编译引擎。
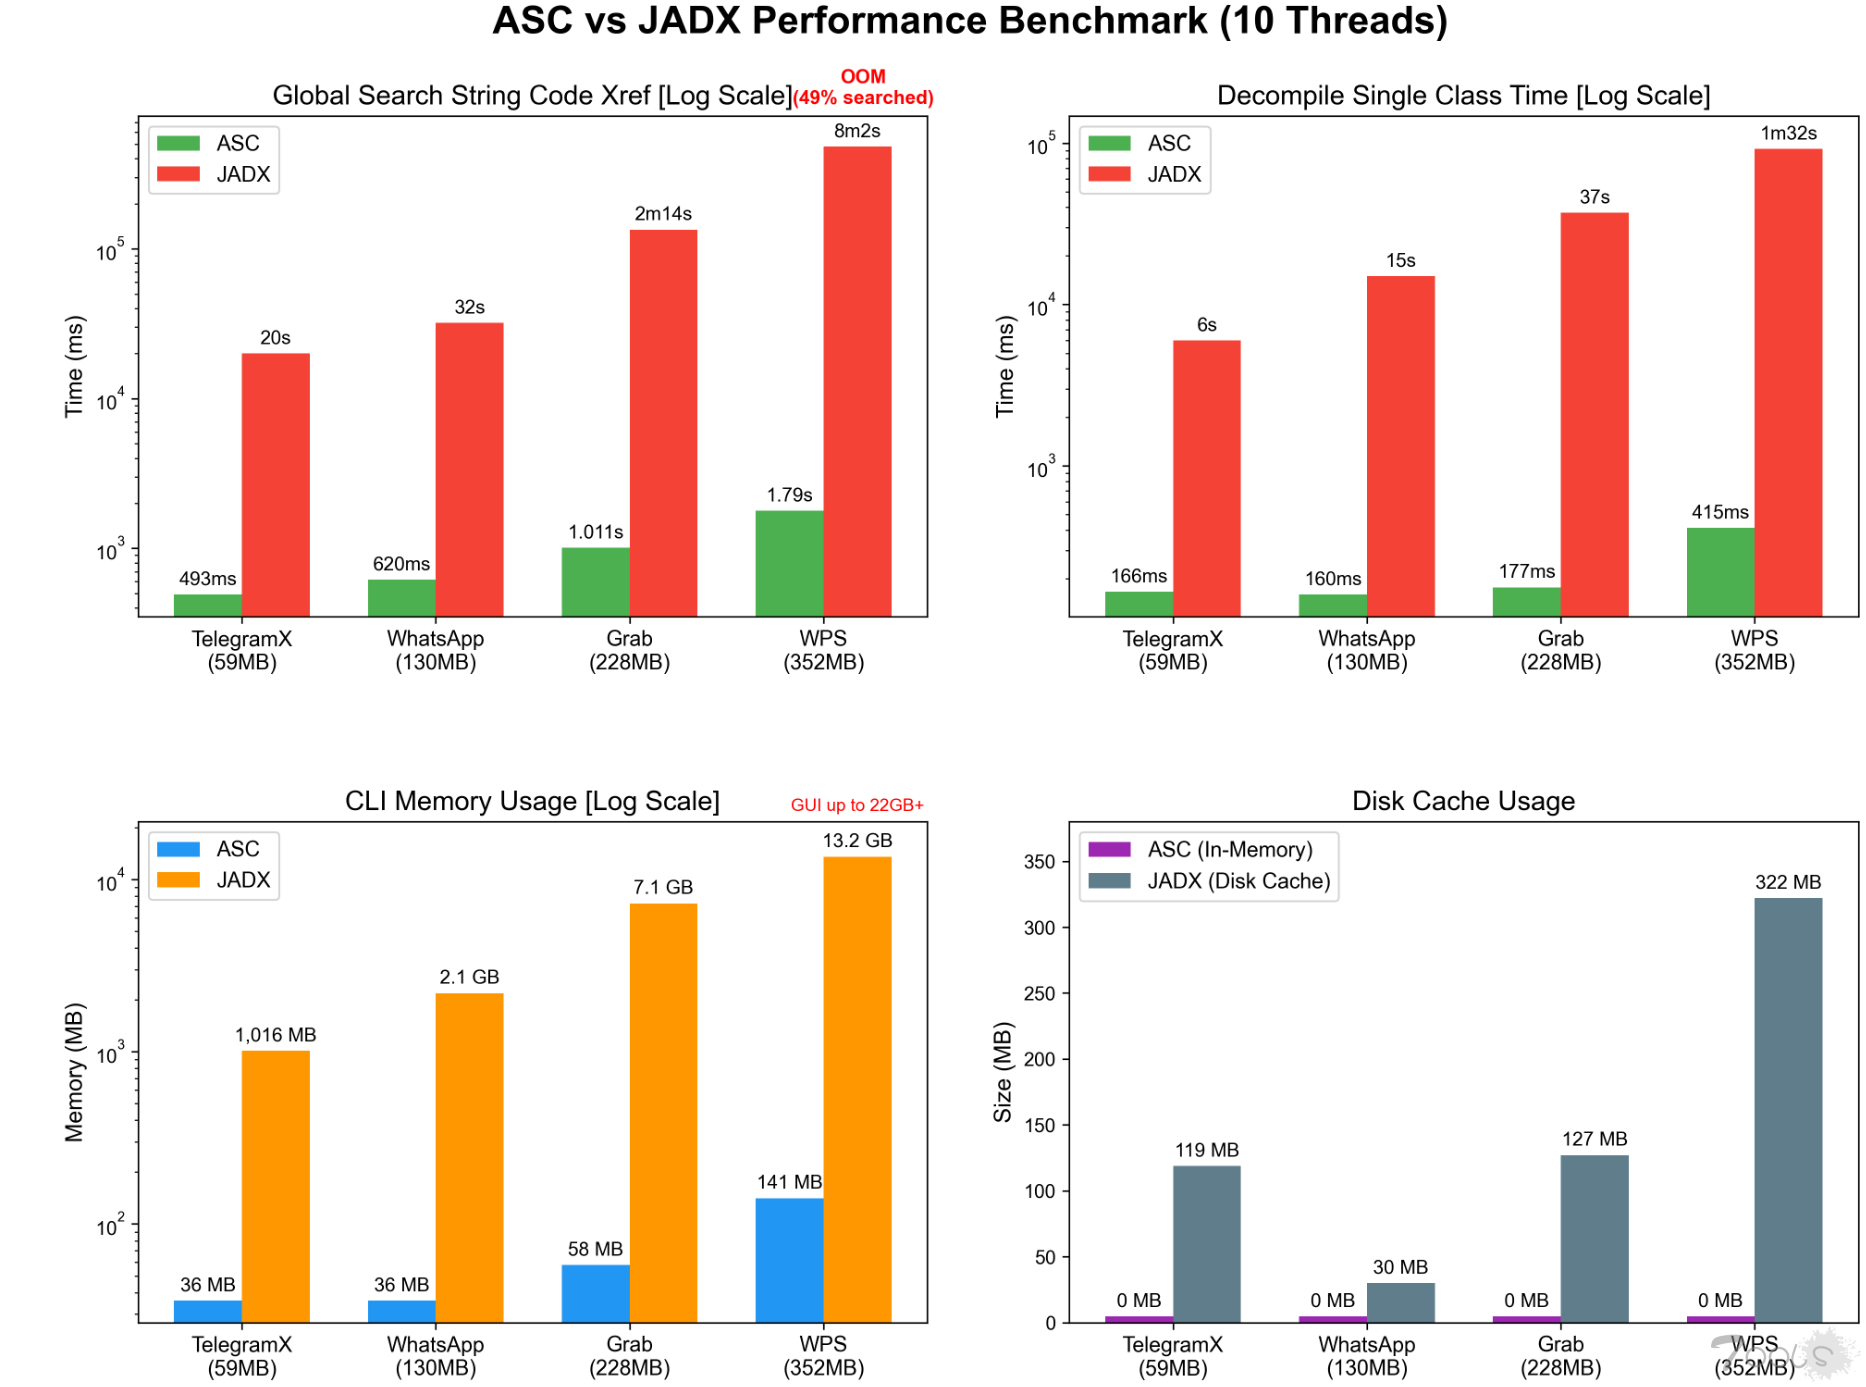
目前的性能测试中,ASC 在 300MB 量级的 APK 中进行全局交叉索引搜索仅用 1.79 秒, 50MB 量级 APK 仅耗时 493 毫秒。详细可见github链接中的测试视频
参考:https://github.com/MG1937/ASC
BlackHat:https://blackhat.com/europe/arsenal/schedule/index.html#droid-asc-r8-compiler-optimization-as-a-decompiler-primitive-54834
就我个人而言,ASC即使在性能差劲的电脑上也可以并行分析数十个APK,这让我完全抛弃了JADX MCP,我做了个实验:
使用Codex Agent + ASC对某个厂商的手机进行分析,并且在几乎没有人工干预的情况下运行了2天(从9月16号到9月18日),Agent自动将设备上所有UID=1000的apk/jar/apex(近100个文件,大部分文件至少有50~100mb大)全部拖出,并使用ASC自动分析,最终我发现了这个设备的一个RCE,一个System UID任意文件写,两个可直接利用的ROOT漏洞,一个受限的ROOT漏洞,一个受到Selinux限制的ROOT漏洞。这个结果令我十分惊讶!
试想一下,如果我使用JADX MCP,一个apk就要有一个JADX实例,每个JADX几乎会占用我电脑一半以上的内存,别说是2天,就是一个月也别想把100个文件分析完
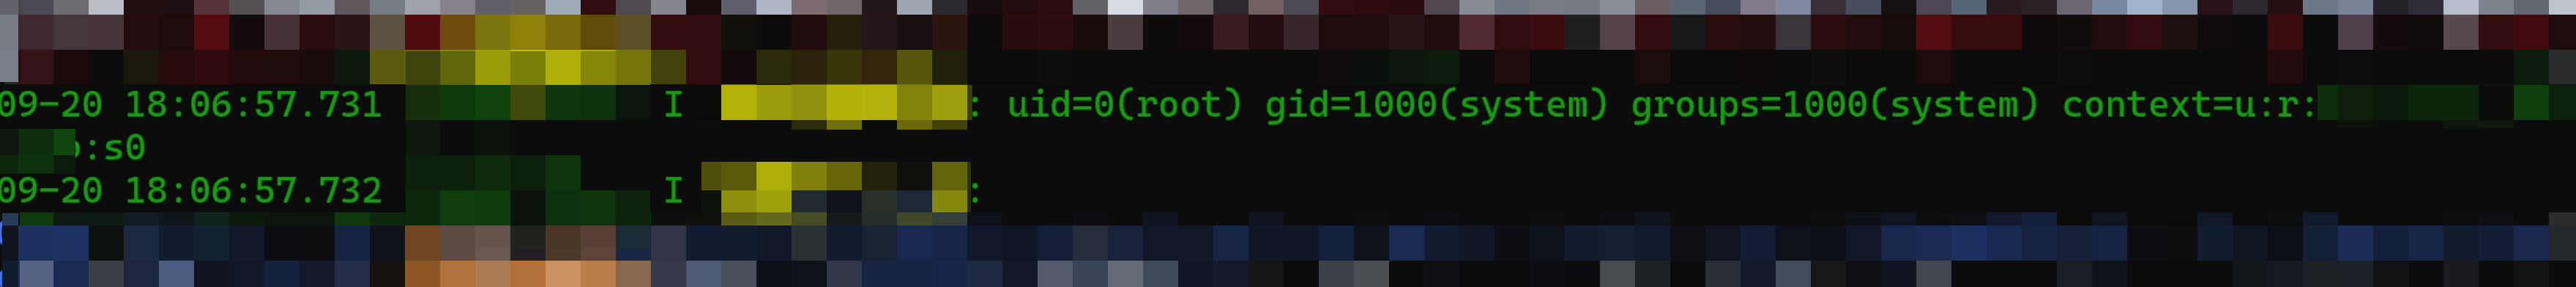
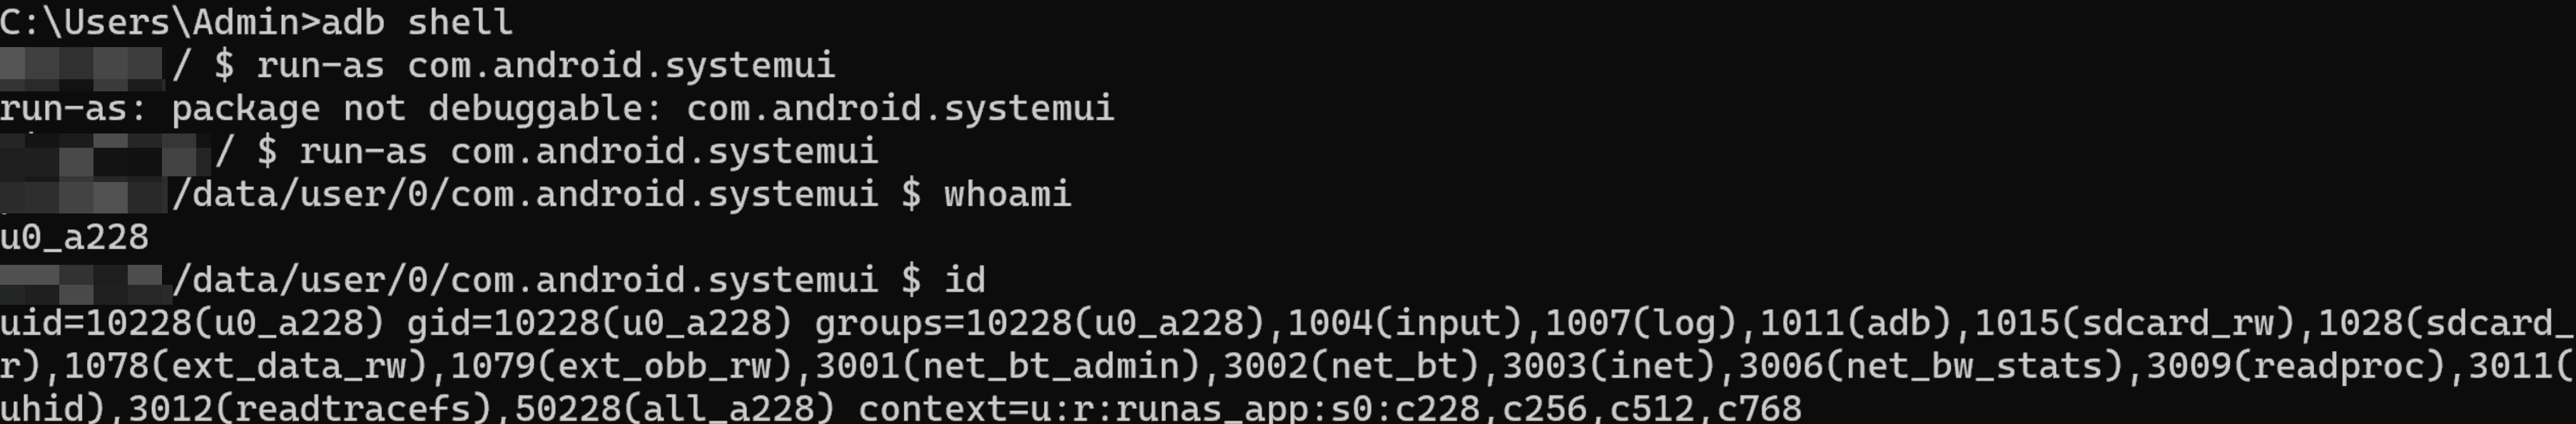
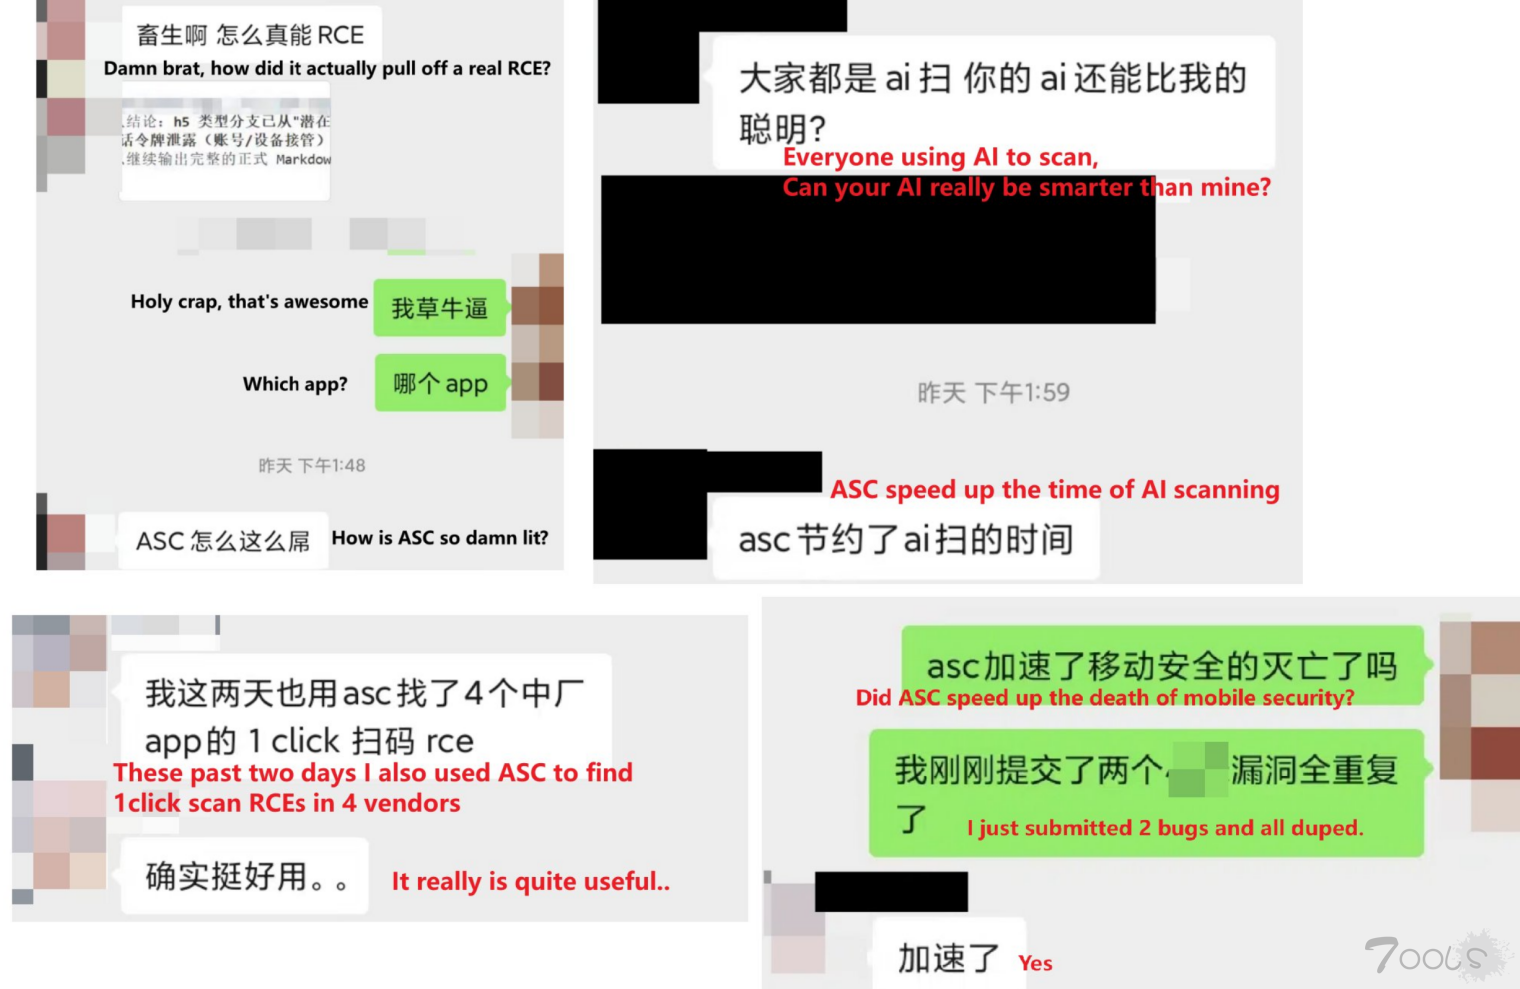
我的许多朋友目前正在使用ASC大批量地扫描各个厂商的App漏洞,并且都收获了不少成果。
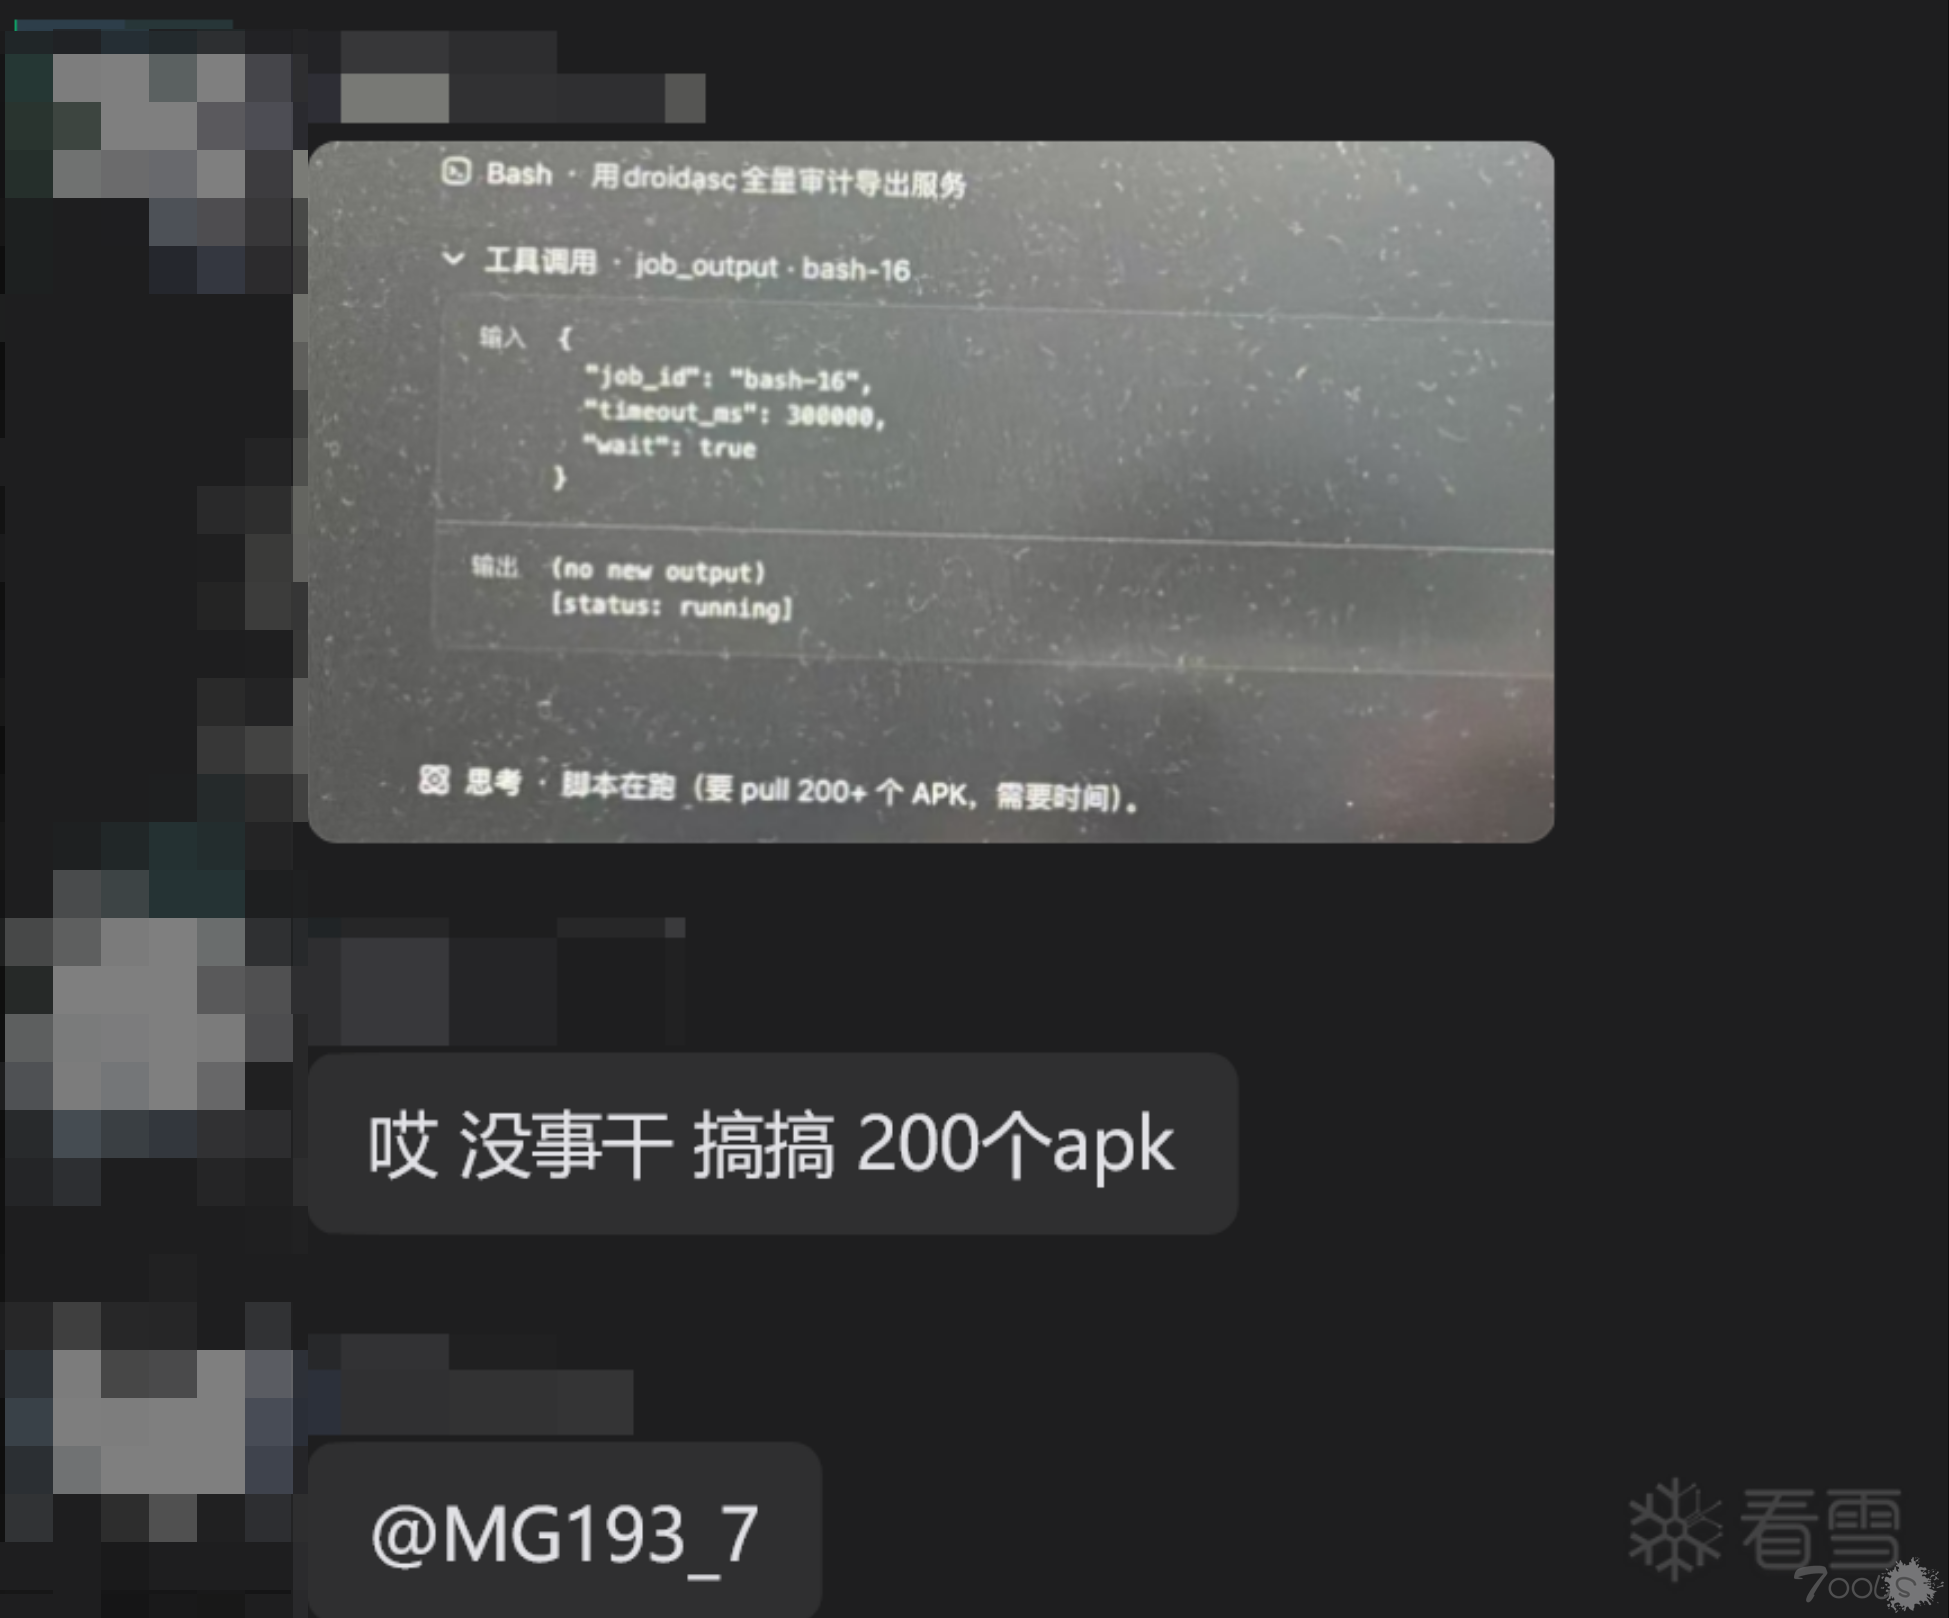
值得一提的是,我的其中两个朋友D***以及L***c(ID脱敏)在服务器上建立了自动化流水线,并且持续地拉取了超过200个APK并使用ASC进行大规模扫描,正在尝试穷尽大部分厂商的所有可挖掘的App漏洞。
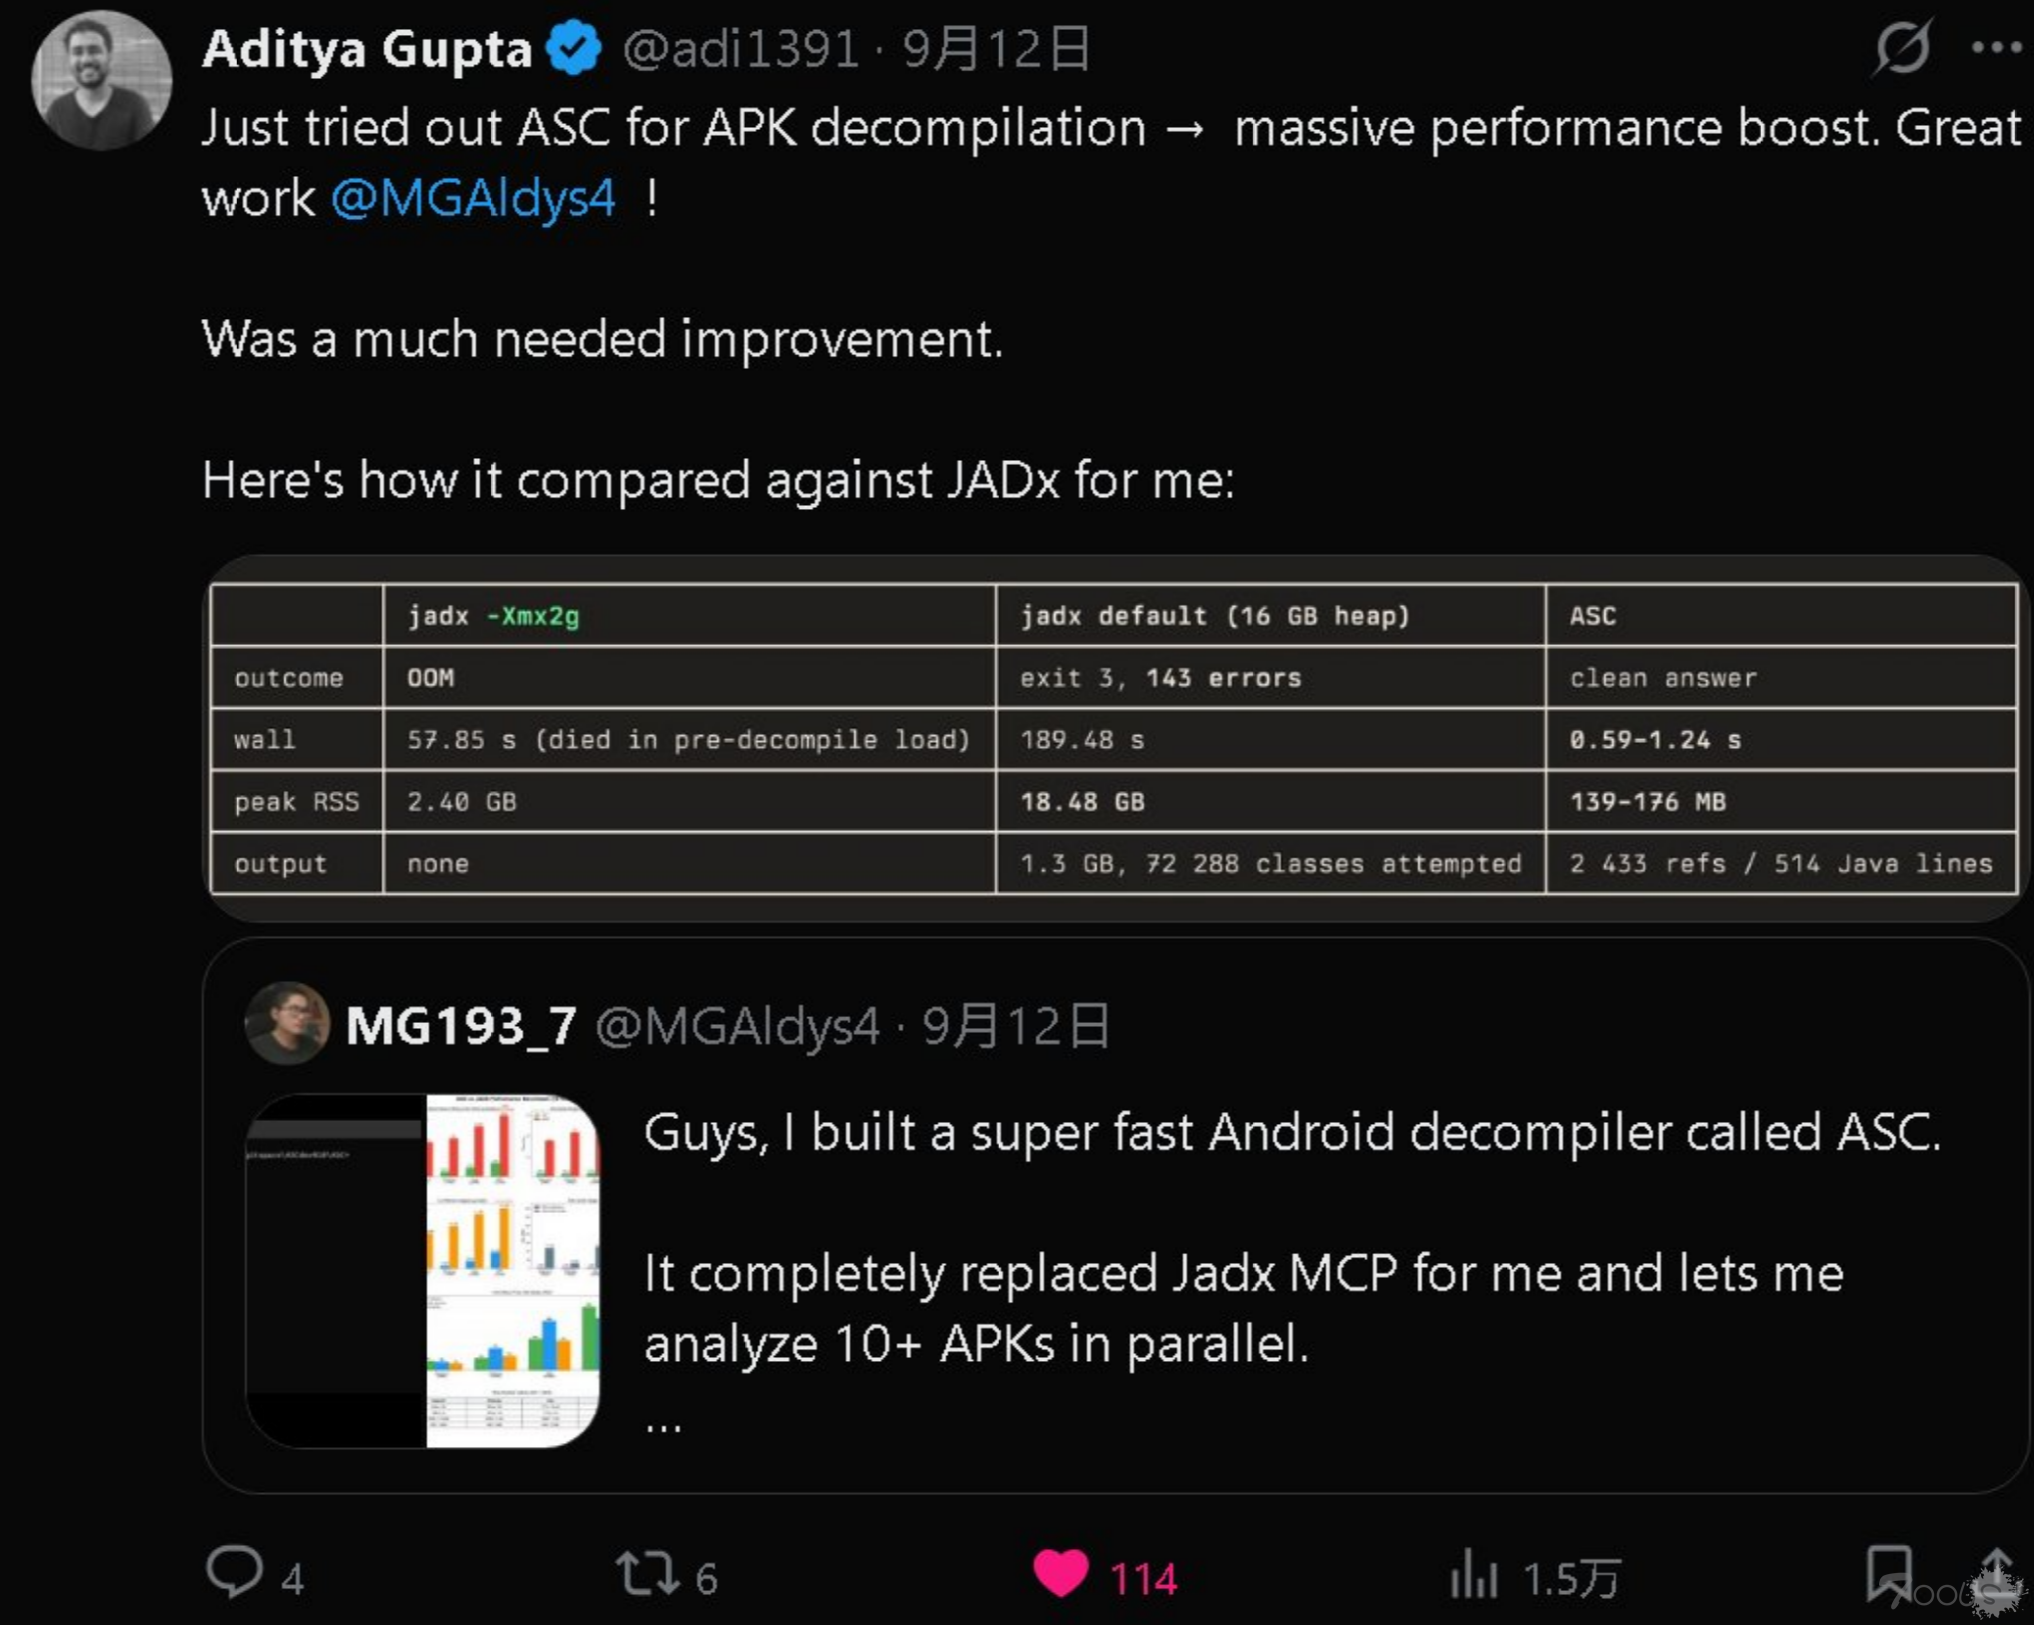
ASC 的首个版本目前由 Python 编写,方便二次定制与修改,可通过pip安装:pip install droidasc
rust版本正在开发,初始版本可见ASC的rust分支
Benchmark
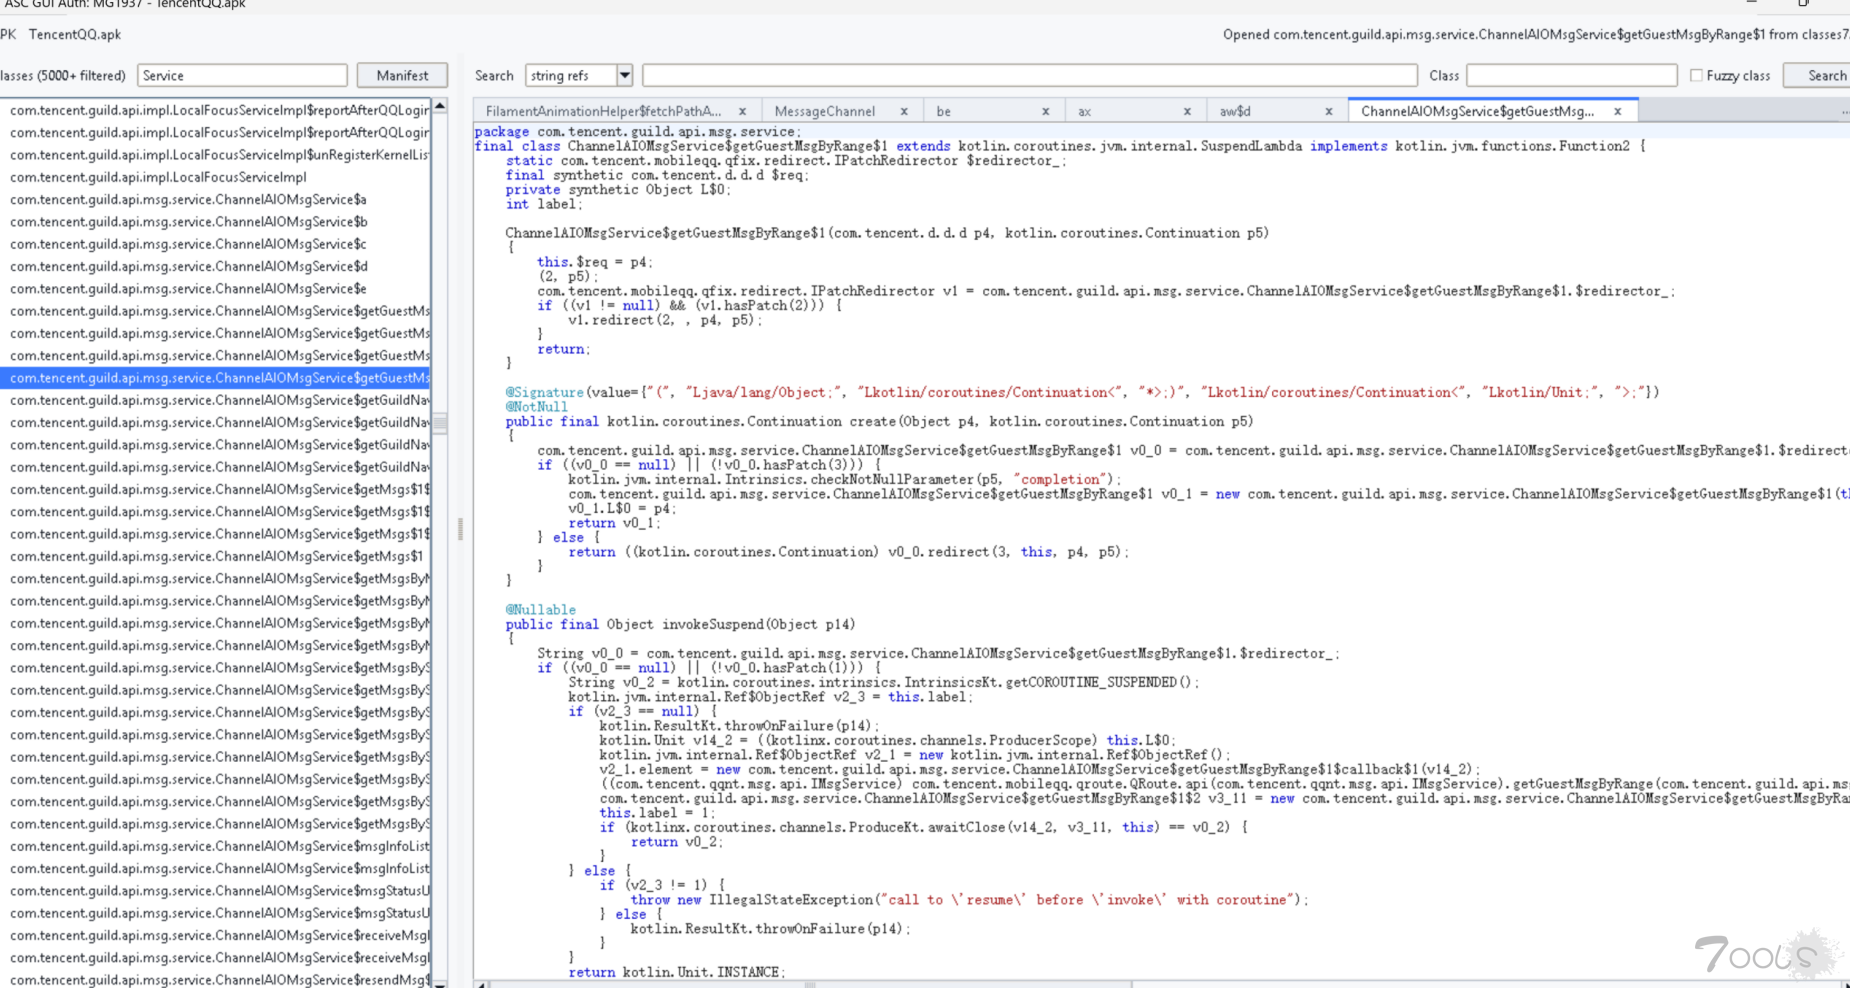
GUI
将APK作为数据库查询
当你获得一个 .db 文件,你是直接使用数据库工具查询 .db 文件内的数据,还是将 db 文件内所有表的结果逐条导出并落地为数万个 json 文件,再用 grep 命令去查询?前者听起来理所当然,后者却正是当下绝大多数反编译器对待 APK 的方式。
Apk作为编译后的产物本身就是高度结构化的数据,现代反编译器却从不利用这一点。它们耗费大量时间与内存,在已经结构化的数据之上重建一个臃肿的代码关系数据库。这种工程思路违背常识:当可以直接从 APK 中毫秒级提取任意代码关系时,这些预处理还有何价值?
与其把反编译器拖入沉重的预处理,不如把编译产物直接当作数据库来查询。ASC 是一个无状态、零预处理的引擎,按需提取与搜索代码,毫秒级完成。具体来说,它的工程实现包含以下几个层面:
- 绕过完整膨胀:不完整解压 APK,而是直接在 Deflate 比特流内部探测,构建密集的 Huffman 查找表,在不触碰无关数据块的前提下提取核心元数据。
- 利用 R8 编译器行为:R8 编译器的确定性常量重定位与指令去重,会在物理布局上留下高度集中的结构。ASC 武器化这一编译器行为,实现极速的跨 DEX 代码搜索。
- O(1) 指令定位原语:将原始字节码偏移映射回方法,无需构建沉重的映射表,即可实现常数时间的方法解析。
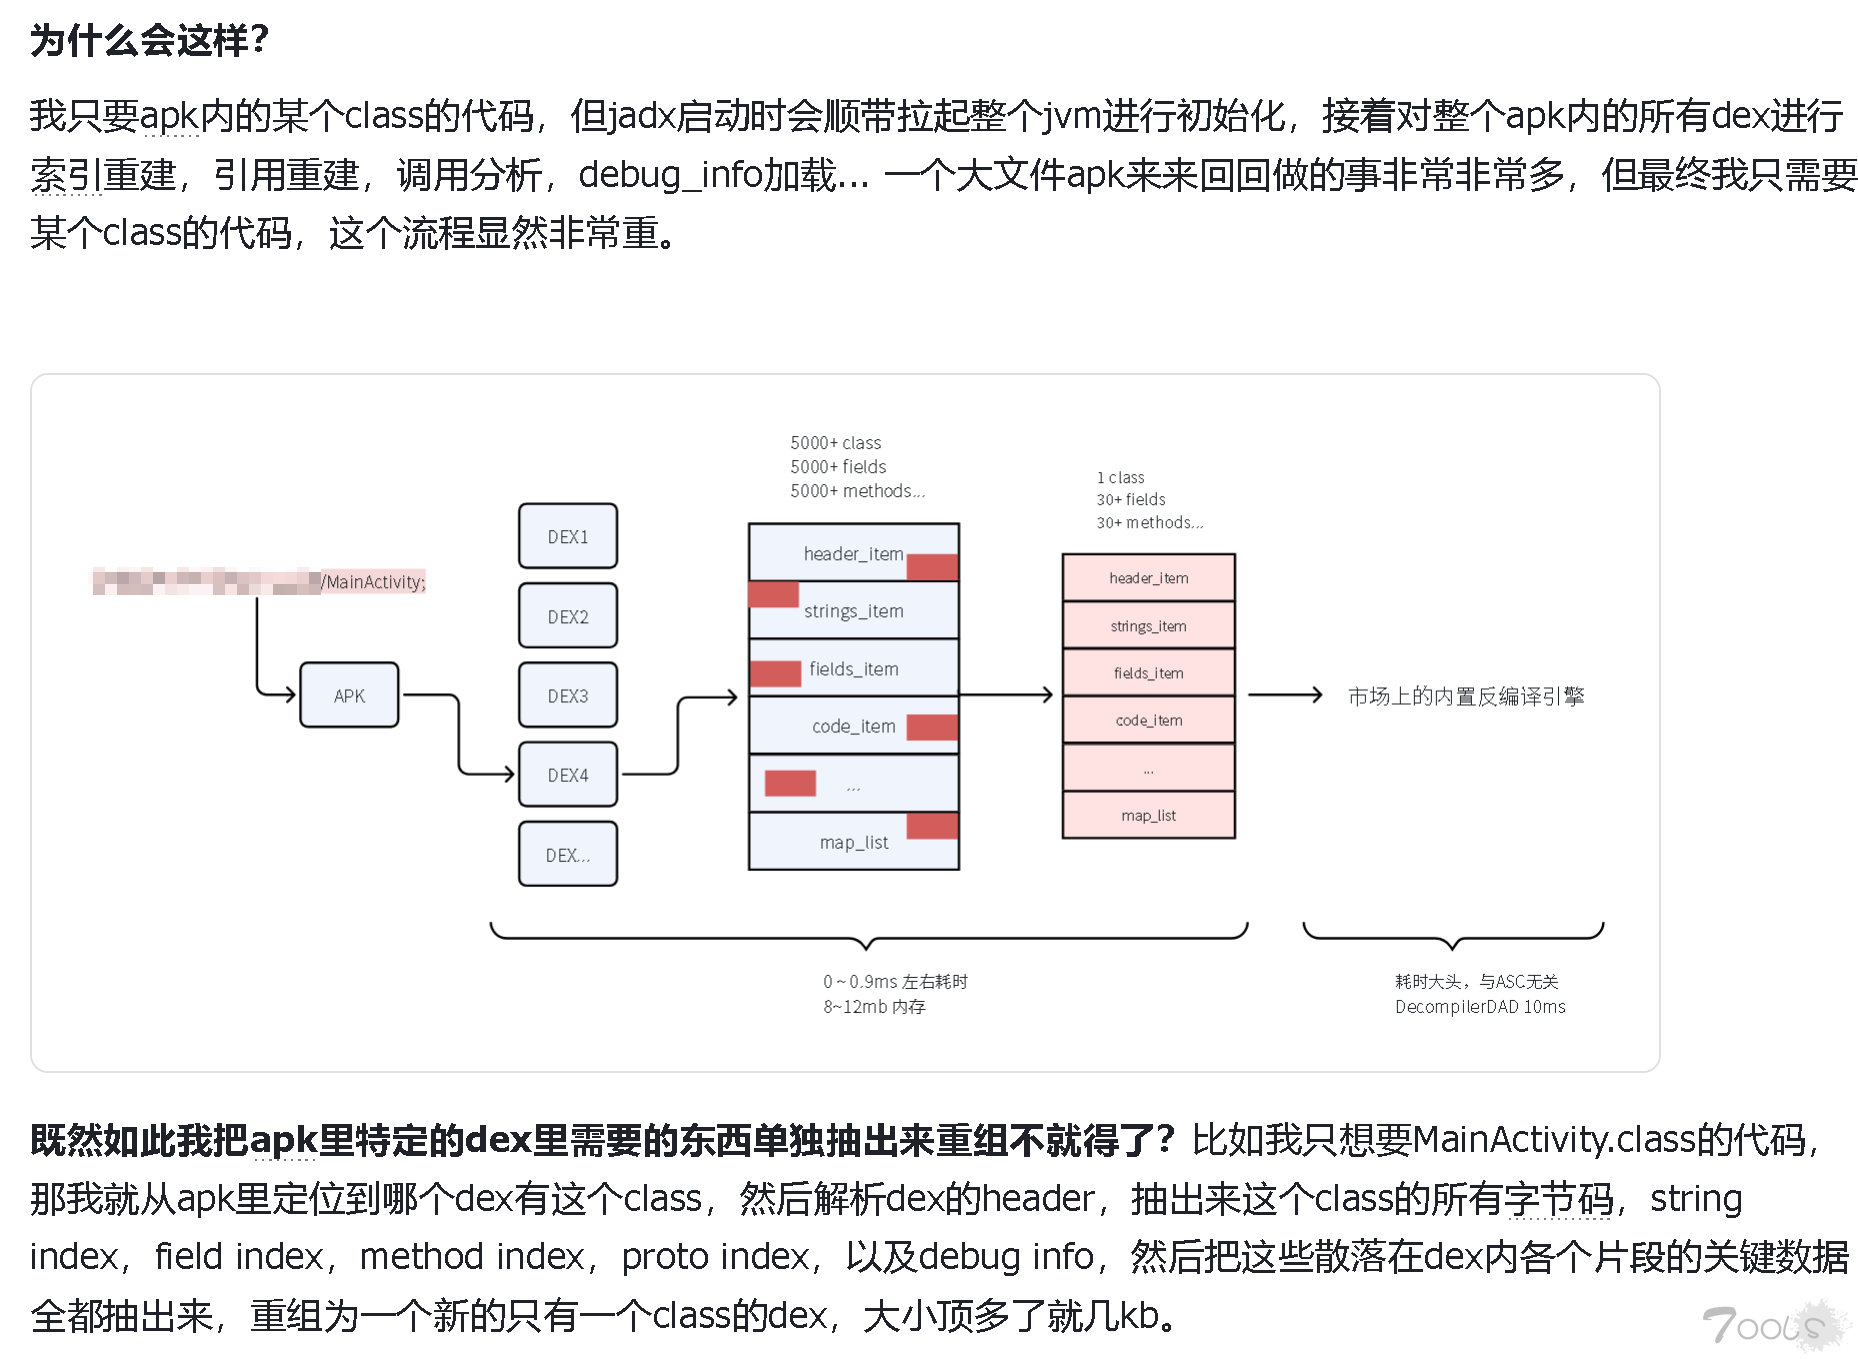
- 按需重组极小 DEX:命中目标后,只提取特定字节码及其依赖,在内存中动态重建一个最小且自洽的 DEX,用于即时反编译。
重组 dex 看似很麻烦,实际上 benchmark 测下来,即使是给 300MB 的 APK 进行重组,也只要 9ms。
常见问题
Q1:ASC 相比 jadx/garlic 的优势是什么?为什么不用 garlic 或者 jadx?
传统做法让 AI 反编译,是希望拿到全量源码。但 jadx 太重,一条流水线分析十几个 APK、开十几个 jadx mcp,机器直接卡死。于是大家宁愿每个 APK 花十几秒甚至几分钟,把伪代码从 APK 内全部导出,garlic 就是这么做的。
但这其实没有必要。APK 本身已经是结构化的数据,如果只需要访问某个 class 的伪代码,就把这个 class 的所有元素抽出来组成一个极小的 dex,再交给下游反编译器即可。既兼顾速度,又能随时切换反编译引擎,把其它引擎优秀的反编译机制为我所用。重组 dex 看似麻烦,实测即使对 300MB 的 APK 做重组,也只要 9ms。
Q2:搜索代码呢?导出之后搜索不是更方便?
一个 APK 只要稍大,导出就非常夸张。作者试过导出 300MB 以上大型 APK 的伪代码,各种 class、小文件碎片直接落盘接近 1GB,甚至连删除都要耗费不少时间。在 1GB 的文件堆里搜索 int xx = yy,可能要几秒,夸张点十几秒,因为这 1GB 不是连续文件,而是好几万个碎片分散存放,搜一次每个文件 IO 一次。
反过来想,原本一个 APK 就 300MB,而且整个文件是连续的,搜代码只要 IO 一次。直接在连续的单文件里搜指令、搜纯字节码,和导出全量源码后跑几万次 IO 去搜索,试想哪个更快?在实际测试中,针对300MB Apk的全局交叉索引搜索速度是 JADX 的269倍,针对 50MB Apk 的全局交叉索引搜索速度则是 JADX 的41倍。而且不导出源码,还可以维护流水线:APK 更新了,拉下来马上就能用 ASC 访问。总不能每拉一个 APK 就全量导出一次,1 个 APK 就是几万个文件,流水线处理多个 APK 就是几十万甚至上百万个文件,没必要。
自评TCV=1
关于作者


评论1次
Droid ASC 技术剖析与攻击视角分析
核心架构
ASC 的设计哲学是 "APK 即数据库",完全颠覆传统反编译器的预处理范式:
关键工程亮点
1. Huffman 探测式解压不完整解 APK,直接在 Deflate 比特流内部构建密集的 Huffman 查找表,提取核心元数据时跳过无关数据块。这与 Ghidra 的内存映射分析策略有相似的哲学——避免不必要的物化。
2. R8 编译器行为武器化R8 的常量重定位和指令去重会在 DEX 物理布局上留下高度集中的结构特征。ASC 利用这一点做极速跨 DEX 代码搜索。这意味着:
3. 极小 DEX 动态重组命中目标后才提取特定字节码及其依赖,在内存中重建最小自洽 DEX 交给下游反编译器。关键点:后端可替换——你可以挂 DAD(脱壳反混淆)、JEB、Procyon 等任何引擎来处理最小 DEX,从而获得每个引擎的最佳反编译效果。
攻击链意义
从红队视角,这东西改变了大规模 Android 漏洞挖掘的游xi规则:
规模化条件具备:
实际可执行的挖掘流水线:
为什么这能挖到 ROOT/任意文件写:厂商预装的特权 APK(特别是 system_server 辅助进程、设备管理服务、OTA 组件)通常:
signature|privileged)这些漏洞的特征模式(特定的 binder stub、反射 invoke 模式、文件路径拼接)在字节码层面非常稳定,ASC 的全局交叉索引让"在 100 个xi统组件里搜一遍"变成秒级操作。
与现有工具链的集成点
--show-bad-code)或 DAD战术级注意事项
威胁景观判断
这种东西的出现意味着 Android 供应链攻击面正在被工业化扫描。任何仍在发布xi统级 APK 的厂商,未来 6~12 个月都会面临这种规模的自动化审计。对防守方(厂商安全团队)来说:
但反过来,对红队来说:这就是当前性价比最高的 Android 大规模漏洞挖掘方案之一,建议尽早集成到内部工具链。