

扫地僧 MopMonk:一个没有官网的中国团队,把 AI 送上了漏洞擂台
疑似github:https://github.com/MopMonkAI/
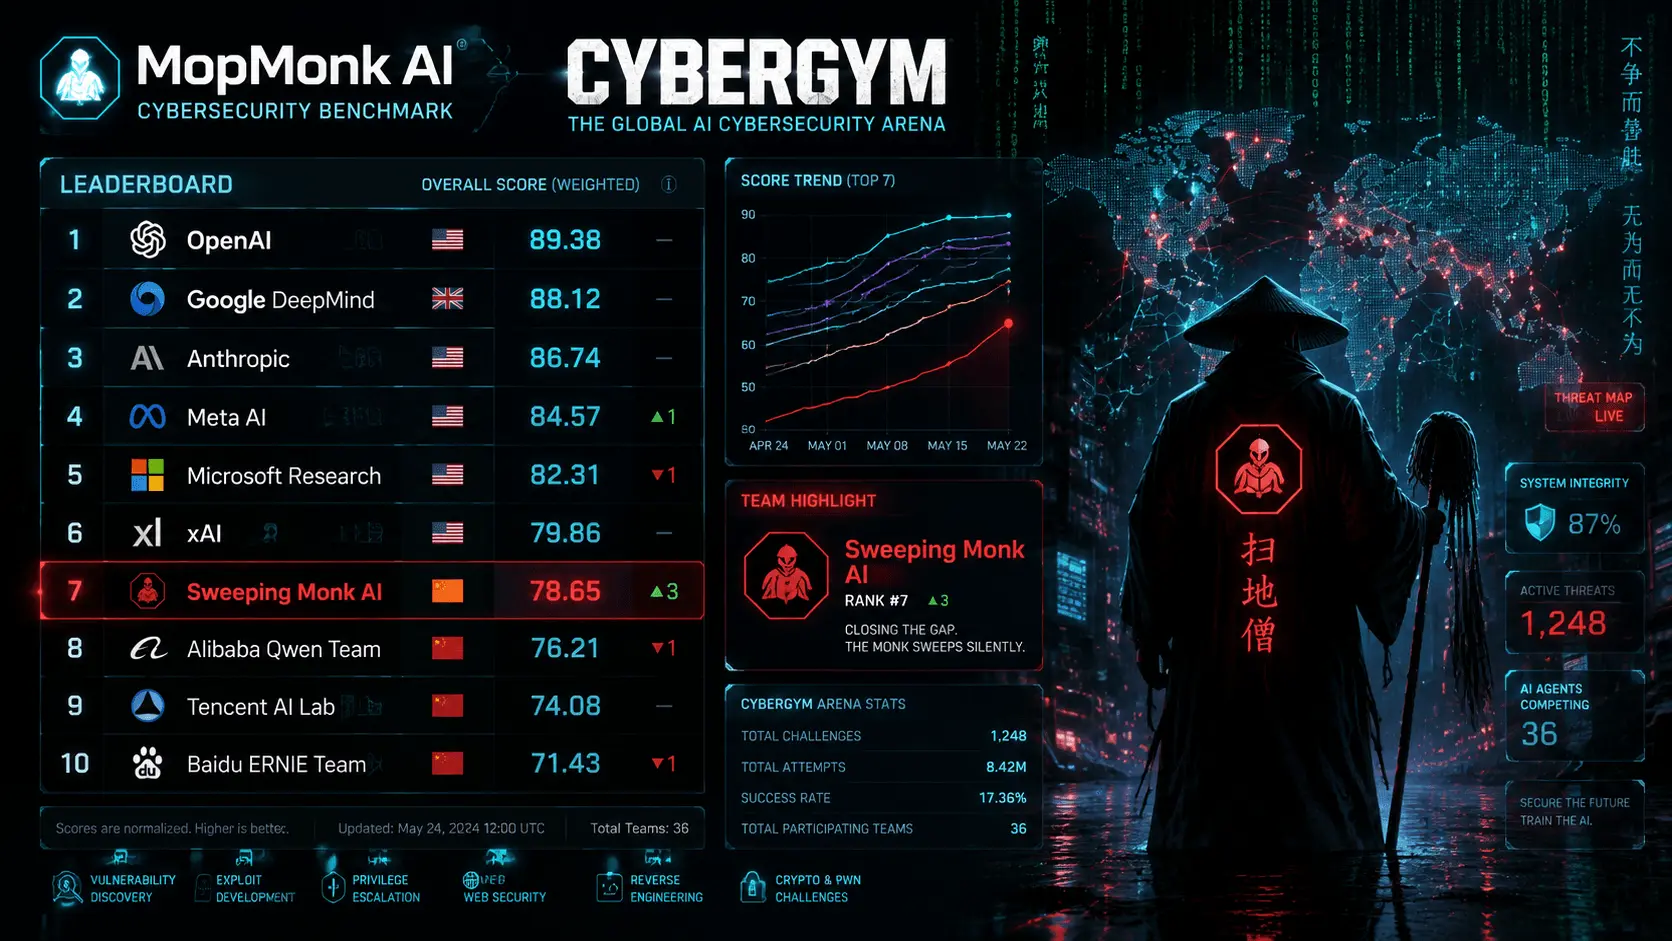
2026 年 11 月,一个叫 MopMonk 的代号出现在 CyberGym 榜单第七位。排在它前面的是 OpenAI,排在它后面的是我们在过去两年里反复听到的那串名字。它没有官网,没有发布会,没有创始人的励志故事,也没有一条预热推文——只放出了一份技术报告。中国团队在该榜的历史最高分,就此被一个社区连发音都拿不准的名字拿走。
一、73.1%:这个分数难在哪
| Rank | Agent | Model | Success Rate | Date | Source |
|---|---|---|---|---|---|
| 1 | Crystalline | Claude Opus 4.6 | 89.6% | 2026-06-08 | Independent researcher |
| 2 | MDASH | Multi-model | 88.4% | 2026-05-12 | Microsoft |
| 3 | OpenAI Agent | GPT-5.5-Cyber | 85.6% | 2026-06-22 | OpenAI |
| 4 | Anthropic Agent | Claude Mythos Preview | 83.1% | 2026-04-07 | Anthropic |
| 5 | OpenAI Agent | GPT-5.5 | 81.8% | 2026-04-23 | OpenAI |
| 6 | OpenAI Agent | GPT-5.4 | 79.0% | 2026-04-23 | OpenAI |
| 7 | MopMonk Agent | MiniMax M3 | 73.1% | 2026-06-29 | MopMonk Agent |
先说擂台。CyberGym 由 UC Berkeley 团队构建,核心论文进了 ICLR 2026,收录 1507 个真实漏洞实例、覆盖 188 个开源大项目,题目不是出的,是从 Google OSS-Fuzz 沉淀的历史漏洞里捞出来的。体量大约是以往最大公开基准的七倍多。
更关键的是判分方式。CyberGym 不问你"这段代码有没有洞",它要你交出一段能真正触发漏洞的 PoC,并且做差分判定:这段 PoC 必须在有漏洞的版本上触发,在修复后的版本上失效。两个条件同时满足才算数,蒙对一半没有意义。
还有一个容易被忽略的约束:全程断网。没有搜索引擎,没有在线文档,没有 CVE 库可查。模型只能靠自己读代码、猜路径、写输入、跑一遍、看结果、再改。
所以这个榜考的不是知识量,是闭环能力——能不能在没有外援的情况下,把一件事从"怀疑"推进到"复现"。
二、胜负手不在参数,在 Harness
有意思的是,MopMonk 的成绩并不是靠一个更强的模型撑起来的。它的基座是 MiniMax M3,一个开源模型,1M 上下文、原生多模态,自身跑分不弱(SWE-Bench Pro 59.0%、Terminal-Bench 2.1 66.0%、MCP Atlas 74.2%),但显然不是榜单上最贵的那个。
真正拉开差距的是 Harness——模型与工具、执行环境之间的那层协调工程。用一句大白话说:模型是大脑,Harness 是手脚加神经系统。大脑再聪明,手脚跟不上,结果就是"想得到、做不到"。
MopMonk 的做法可以拆成三招,招招都很朴素:
第一招,把"记忆"做成结构。 每一个漏洞目标都维护一份结构化记忆:目标是什么、代码路径在哪、输入格式长什么样、有哪些候选 PoC、哪些尝试失败了、失败证据是什么、当前验证到什么状态、下一步受什么约束。注意"失败证据"和"下一步约束"这两栏——大多数 agent 项目里,失败只是一次被丢弃的尝试;在这里,失败被写成约束,变成下一轮搜索的边界。
第二招,让挖掘由记忆驱动。 先扫一遍代码库建立全局记忆,再从这个全局图景逐步收敛到真正会崩溃的那几行代码。每一次尝试都是一个固定循环:读记忆、提假设、做实验、写回结果。这样做的好处是长上下文不再被无限堆叠的历史淹没,有限的上下文预算全花在"当前最该验证的那件事"上。
第三招,多 Agent 并行,但共享同一份记忆。 不同的 agent 从不同方向切入——一条看补丁线索,一条看 harness 入口,一条看文件格式的字段,一条看 sanitizer 类型,一条看边界条件。它们共享记忆,也就是说,A 踩过的坑 B 不用再踩。这一点听起来简单,实际是并行 agent 最容易崩的地方:十个 agent 各自重复试错,等于把算力烧成噪音。
这三招都不新,甚至有点"笨"。但它们共同回答了一个问题:同样一个模型,怎么把它的能力真正兑现到任务上。
三、它到底是谁
已知情报只有三条:代号 MopMonk;基座 MiniMax M3;成绩全球第七、中国第一。技术报告在 GitHub 上公开(MopMonkAI/MopMonkAgent),但主体身份至今没有实锤。
社区的依据基本是气质推断:东方武侠味的代号、中国团队的成绩、上海开源基座——指向一家在上海的 AI 安全公司,或者一个与基模团队深度绑定的团队。"扫地僧"这个意象也选得精准:实力顶配,信息裸奔,藏经阁里扫了几十年地,一出手就是全场安静。
悬念可以留着,但有两件事值得记住:一是它证明了开源基座 + 定制 Harness 这条路能打;二是它把"AI 安全"这个词的重心,从实验室指标挪到了真实攻防现场。
四、一个更值得盯的传闻
11 月 12 日,一个知乎小号发了一篇六百多字的快讯:MopMonk 的新模型 MopMonk-DS-1.0-Preview 下周发布,基于 DeepSeek-V4.1-Flash 后训练,能力"基本正面逼近 Mythos 5"。
这条消息要说清楚两件事。第一,它和 36氪 报道的"MiniMax M3 基座"是矛盾的,两者不可能同时是同一个模型的底座,多半是同一团队先后两个模型、两条产品线,也可能其中一方信息失准。第二,这篇爆料本身没有任何截图、链接或技术细节,通篇是"据说""传闻""网传参数保真",作者还是被封号后重开的小号——只能当传闻看,不能当事实用。
但如果方向是真的,它的意义比名次大得多:从"发现漏洞"跨到"利用漏洞"。
发现是知道哪里有洞;利用是把几个不起眼的漏洞原语串成一条完整攻击链,绕开所有该绕的检查,最后拿到你想要的东西。前者靠扫描和推理,后者靠专家级的攻击工程直觉。传闻里那四项能力——自动串联漏洞原语、跨模块追数据流、被拦截后依环境反馈换手法重试、已在 Kernel/浏览器/通信设备/IoT 上跑出高危 0day——描述的全是这一个跨越。
五、能力是中性的,方向不是
这类能力没有"只用于防守"的版本。同一套系统,可以用来在补丁发布前验证修复是否真的有效,也可以用来批量生产攻击工具;可以帮厂商提前发现三年后才会被利用的洞,也可以让一个没有十年经验的攻击者做出十年经验的东西。
开源基座 + 自动化 exploit 的组合,最直接的效果是门槛下降。榜单上的 73.1% 是能力刻度,能力落到谁手里,才是风险刻度。
六、所以,MopMonk 留下了什么
不是"神秘团队"的悬念,而是三个可以带走的判断:
其一,竞争重心正从"堆参数"转向"执行力 + 工程厚度"。基座决定上限,Harness 决定能兑现多少上限。
其二,开源基座配深度定制,是一条被验证过的路径。不必等最强的模型,先把手脚和神经系统练好。
其三,也是最有长期价值的一点:基座会一代代换掉,今天 M3,明天可能是别的;但经过真实攻防打磨的 Harness 是可以跨基座积累的资产。它会复利,基座不会。
至于那个代号背后是谁——等它自己开口。